SEO & GEO Sander·Teamlead SEO, GEO & Website
Wat de langste Google spam-update van het jaar betekent voor jouw site
Sander·Teamlead SEO, GEO & Website Google Premier Partner
 Meta Business Partner
Llms.txt-adoptie groeide 8,8x, maar 97% van de bestanden krijgt nul AI-verzoeken. Dit is wat wel werkt voor je GEO-vindbaarheid.
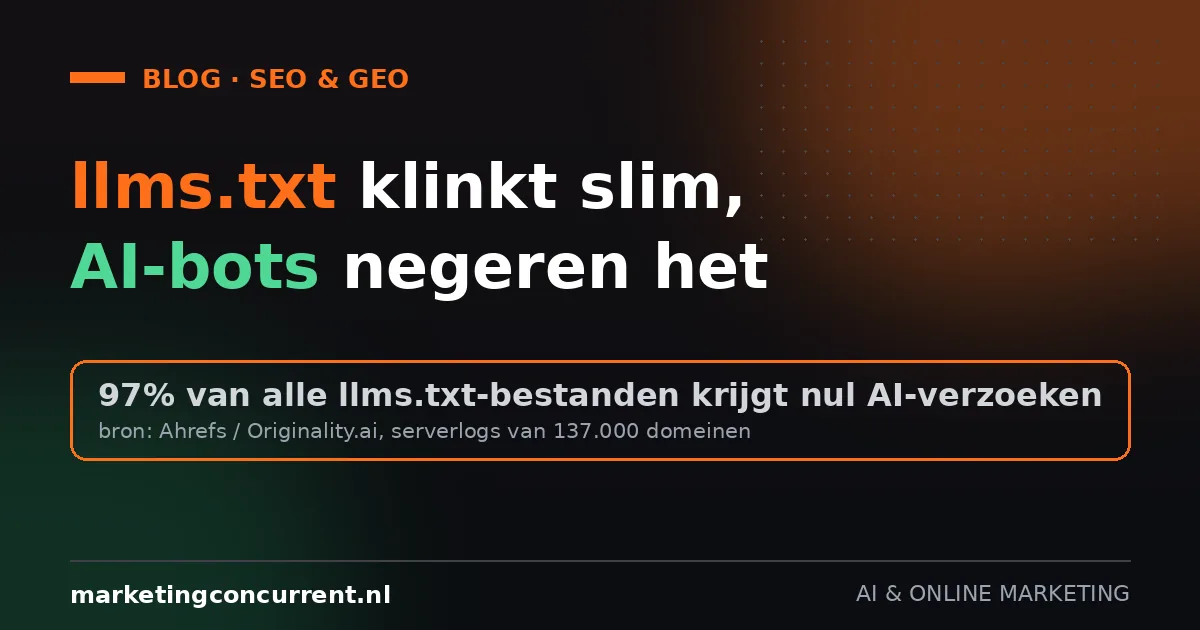
Steeds meer Nederlandse bedrijven zetten een llms.txt-bestand op hun site, in de hoop dat ChatGPT, Perplexity of Google's AI-modus hun merk dan vaker noemt. Het aantal van dit soort bestanden groeide het afgelopen jaar bijna negen keer zo hard. Toch blijkt uit serverlogs van 137.000 domeinen dat liefst 97 procent van die bestanden geen enkel verzoek van een AI-bot krijgt. Voor je vindbaarheid betekent dit vooral dat je niet blind moet meedoen met deze nieuwe hype. Een llms.txt-bestand kan geen kwaad, maar het is geen vervanging voor goede content, duidelijke structured data en een site die GEO-proof is ingericht voor de AI-zoeksystemen die er echt toe doen.
Wat we bij websites regelmatig voorbij zien komen, is een bureau of developer die enthousiast een llms.txt-bestand toevoegt en dat afvinkt als "AI-optimalisatie". De cijfers hieronder laten zien waarom dat voor de meeste MKB-sites weinig oplevert, en wat wel werkt.
Een llms.txt-bestand is een simpel tekstbestand op je domein, vergelijkbaar met robots.txt, maar dan bedoeld als leeswijzer voor taalmodellen. Het bevat een titel, een korte samenvatting van je site en een lijst met links naar je belangrijkste pagina's, zodat een AI-systeem in theorie sneller snapt waar je site over gaat. Het idee komt oorspronkelijk uit de ontwikkelaarswereld en is nooit een officiële standaard van Google, OpenAI of Anthropic geworden. Sites kunnen het vrijwillig toevoegen, en steeds meer doen dat ook.
De cijfers over de groei zijn best indrukwekkend. Onderzoeksbureau Originality.ai telde in juni vorig jaar ruim vierduizend llms.txt-bestanden op het web. Een jaar later waren dat er ruim zesendertigduizend, een groei van 8,8 keer. Tel je de varianten llms-full.txt en ai.txt mee, dan komt het totaal uit op bijna veertigduizend sites. Onder de top tienduizend domeinen wereldwijd heeft inmiddels ruim 9 procent zo'n bestand staan, met reisbranche en financiële dienstverlening voorop en e-commerce er net iets onder.
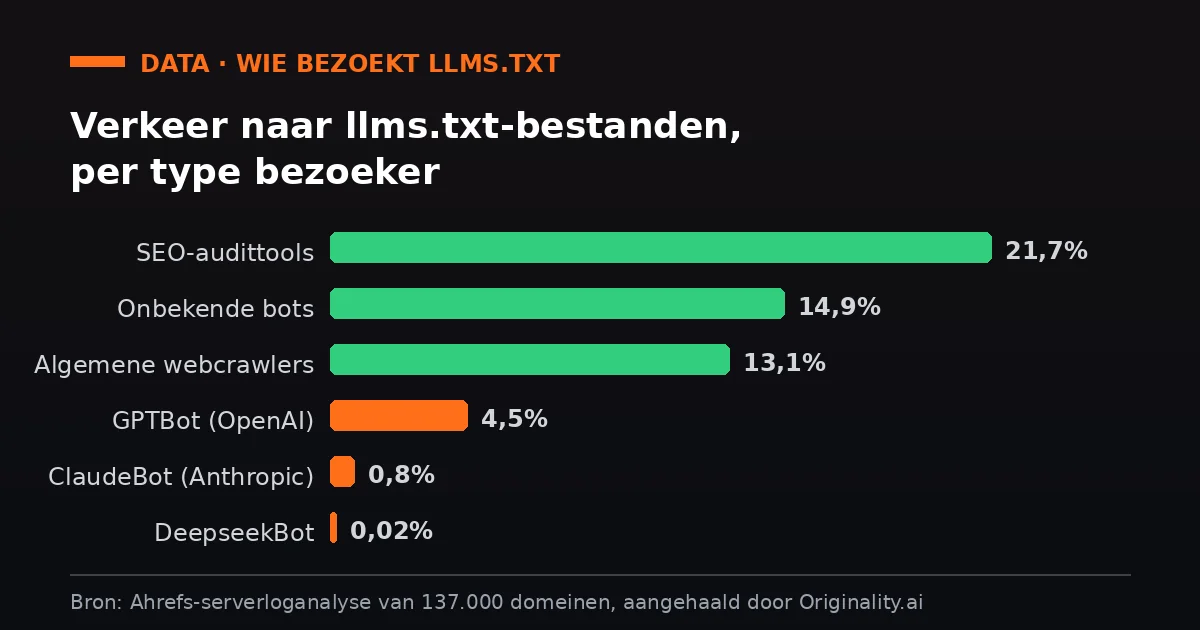
Hier wringt de schoen. Ahrefs analyseerde serverlogs van 137.000 domeinen en vond dat 97 procent van de llms.txt-bestanden geen enkel verzoek ontving van een AI-systeem. De bots die je site wel crawlen voor training of beantwoording van vragen, besteden er nauwelijks aandacht aan. GPTBot van OpenAI was verantwoordelijk voor 4,5 procent van het verkeer naar deze bestanden, ClaudeBot van Anthropic voor minder dan 1 procent en DeepseekBot voor een verwaarloosbare 0,02 procent. Opgeteld maakten alle AI-bots samen maar 1,1 procent uit van het totale verkeer naar llms.txt-bestanden.
Wie bezoekt die bestanden dan wel massaal? Vooral SEO-audittools, goed voor 21,7 procent van het verkeer, gevolgd door niet-geïdentificeerde bots en gewone webcrawlers. Met andere woorden, het zijn vooral marketeers en tools die elkaars llms.txt-bestanden controleren, en niet de taalmodellen zelf.
Een bestand dat AI-bots amper openen, kun je geen GEO-strategie noemen. Het is op zijn best een visitekaartje dat in de brievenbus blijft liggen.
Common Crawl bekeek bijna zeshonderdduizend llms.txt-bestanden uit een recente crawl en trof flink wat rommel aan. Net de helft volgde de voorgeschreven opbouw met titel, samenvatting en secties. Een derde voorzag links van een korte beschrijving, zoals de specificatie eigenlijk vraagt. Ruim twee derde van alle bestanden bleek gegenereerd door een website-bouwer, waarbij Wix alleen al verantwoordelijk was voor 41 procent van het totaal. Bij ruim 10 procent van de "geldige" bestanden stond er in werkelijkheid gewoon een robots.txt-bestand onder de verkeerde naam. Onderzoekers vonden zelfs een handvol bestanden met pogingen tot prompt-injectie, tekst die bedoeld is om een AI-systeem stiekem andere instructies te geven. Geen grote plaag, maar wel een teken dat het hele format nog erg rommelig is.
Een llms.txt-bestand toevoegen kost een kwartiertje en schaadt niets, dus er is geen dringende reden om het te verwijderen als je het al hebt. Maar verwacht er geen wonderen van. Steek je tijd liever in de dingen waarvan uit onderzoek blijkt dat AI-systemen ze daadwerkelijk oppikken. Denk aan heldere pagina's met een duidelijk antwoord in de eerste alinea, correcte structured data, snelle laadtijden en, minstens zo belangrijk, een robots.txt die de echte AI-crawlers zoals GPTBot en ClaudeBot niet per ongeluk blokkeert. Check in je serverlogs of Search Console of deze bots je site überhaupt bezoeken voordat je verwacht dat een los tekstbestand het verschil maakt. Werk je aan je bredere vindbaarheid in zoekmachines, dan blijft SEO bureau het fundament waar GEO op voortbouwt, niet een los bestandje erbij.
Benieuwd hoe dit zich verhoudt tot andere technische AI-maatregelen? In onze eerdere artikelen over GEO en technische vindbaarheid, te vinden via het overzicht van GEO-artikelen op het blog, gaan we dieper in op wat wel aantoonbaar werkt.
Twijfel je of jouw site klaar is voor AI-zoeksystemen, of wil je weten waar je het beste in kunt investeren? Plan een strategiegesprek en we kijken samen naar wat voor jouw site echt prioriteit heeft.
Nee, dat hoeft niet. Het kost geen rekenkracht of crawlbudget van betekenis en kan in de toekomst relevanter worden als AI-systemen het format serieuzer gaan gebruiken. Zie het als een kleine moeite, niet als een prioriteit.
De grote taalmodellen halen hun informatie vooral uit hun reguliere crawl- en indexeringsproces, net als een gewone zoekmachine. Een apart samenvattingsbestand lezen tijdens het beantwoorden van een losse vraag is technisch kostbaar en traag, en de meeste systemen doen dat simpelweg niet structureel.
Uit de onderzoeken waarop dit artikel is gebaseerd, blijkt vooral dat toegankelijkheid voor de echte crawlers, correcte structured data en pagina's die een vraag direct en volledig beantwoorden, de factoren zijn waar AI-systemen wel op reageren. Dat zijn ook precies de basisprincipes van technische SEO.
Leidt het team voor SEO, GEO en websites en werkt aan zichtbaarheid in Google én in AI-antwoorden, van techniek tot content. Vragen over dit artikel? Plan een strategiegesprek of bekijk het hele team.
Sander·Teamlead SEO, GEO & Website Sander·Teamlead SEO, GEO & Website